Proxmox VE y los servicios de almacenamiento de objetos: pensando en voz alta
Tengo un clúster PVE respaldado por Ceph. El almacenamiento en bloque (RBD) y el sistema de archivos compartido (CephFS) aparecen como ciudadanos de primera clase en la interfaz. Ceph también trae una implementación de S3 perfectamente buena, el RADOS Gateway, y esa todavía la armo a mano, aparte, como un secreto culposo.
Así que me senté con la versión de mí que ya encontró tres razones por las que esto no va a funcionar: un listener expuesto a Internet en los hipervisores, un modelo de tenants que Proxmox no tiene, y un fork de pve-manager que cargaría para siempre. La pregunta era si integrar RGW en Proxmox como corresponde vale la pena de todos modos. Aquí no hay código para instalar; esto es una discusión de diseño, y las notas de trabajo viven en pve-objectstorage.
La comezón
— Yo: Ya tengo Ceph debajo. ¿Por qué no estoy sirviendo S3 directamente desde los hipervisores?
— También yo: Porque hoy lo creas con radosgw-admin, escribes a mano una unidad de systemd, pones un balanceador de carga adelante y rezas para que nadie lo toque en la próxima actualización del clúster. Funciona, pero es una mascota, no una funcionalidad.
El bloque y los archivos no son mascotas. Se declaran, se agrupan en clúster y se administran desde el mismo lugar que todo lo demás. El clúster ya está ahí, los OSD ya están ahí, los datos ya están ahí. Lo único que falta es que Proxmox trate el almacenamiento de objetos como algo propio en lugar de algo que yo metí de contrabando.
La respuesta de moda es Rook, o algún operador de Ceph detrás de MetalLB. No voy a arrastrar un plano de control de Kubernetes a nodos PVE bare-metal para repartir buckets S3: un segundo sistema distribuido que cuidar y un segundo dominio de fallas, todo para exponer un daemon que Ceph ya compila y PVE ya empaqueta.
— También yo: Entonces toma la respuesta aburrida de Proxmox. Pon HAProxy y RGW en un contenedor LXC, deja que ha-manager lo mueva y no parchees nada.
— Yo: Esa es la mascota otra vez, solo que dentro de un contenedor. El huésped igual necesita claves de Ceph y una ruta hacia la red del clúster, agrega un salto a cada petición, y su ciclo de vida sigue siendo manual. Y sí, el dashboard de Ceph ya puede administrar usuarios, buckets y cuotas de RGW. Lo que no puede es hablar el idioma de los permisos de PVE ni vivir en el mismo panel que todo lo demás que corro.
El stack nativo tiene todo lo que necesito: pveceph, systemd, ifupdown2 con VRF de Linux, y HAProxy. La restricción se escribe sola: systemd nativo + VRF + HAProxy, nada más.
Mantener el daemon tonto, y después ocuparse de la red
Mantén simple el daemon RGW: RADOS Gateway pelado sobre el servidor Beast embebido, atado a una IP privada en el puerto 7480 (el valor por defecto de rgw_frontends a secas; cephadm usa el 80), traduciendo HTTP a llamadas de Ceph. Sin TLS, sin binding público, sin inventos. Si se muere, systemd lo levanta de nuevo. Proxmox se encarga de la automatización poco glamorosa a su alrededor: claves de cliente de Ceph, inicialización de realm y zonegroup para una sola zona (multisite queda fuera de la v1), las unidades de systemd. Las cosas que siempre hago sutilmente mal a las 11 de la noche.
El tráfico de HAProxy a Beast cruza entre nodos como HTTP plano. SigV4 protege las credenciales, no el contenido, así que esto asume una red de backend confiable; TLS hacia los backends queda como opción para los sitios que no la tengan.
— Yo: Entonces el asistente de pools es fácil. Eliges un pool de índice, eliges un pool de datos.
— También yo: Así no piensa RGW. Un bucket recibe un placement target cuando se crea, y eso no se puede cambiar después. Dentro del target, las storage classes se eligen por objeto, al subirlo o mediante una regla de ciclo de vida.
Así que el asistente modela placement targets y sus storage classes, no dos desplegables de CRUSH. Debajo de eso, claro, una regla NVMe rápida para el pool de índice replicado, una regla HDD o un perfil EC para los datos masivos. Y la trampa que solo aparece en producción: un pool de datos con erasure coding necesita que data_extra_pool apunte a un pool replicado, porque EC no puede guardar omap. Si lo dejas sin configurar, RGW recurre al pool de datos EC, y las subidas multipart fallan. El asistente debería configurarlo automáticamente, y convivir con la interfaz de pools y autoscaler que PVE ya tiene en lugar de pelearse con ella.
Después viene la parte en la que todos estos diseños mueren en silencio: poner HAProxy adelante. Un nodo PVE ya tiene otras cosas que quieren el puerto 443, en redes que no tienen nada que ver entre sí. Haz bind a *:443 y acabas de armar una mina comodín: el próximo listener en el 443 choca, o expones un endpoint en una red que no tenía por qué tocar. Así que la regla es absoluta: HAProxy nunca hace bind a comodines. IPs explícitas, punto, y el generador se niega a emitir una configuración que rompa eso. Para mantener el ingreso fuera del underlay, el frontend público hace bind dentro de una VRF como vrf-public.
— También yo: Cuidado con esa VRF. Arranca todo HAProxy con ip vrf exec vrf-public y cada socket que abra cae en esa VRF, incluidas las conexiones de backend hacia RGW en la red privada. Esas mueren a menos que filtres rutas entre tablas. Tampoco es un sandbox: ip vrf exec engancha un hook BPF de cgroup que ata los sockets nuevos al dispositivo VRF, más parecido a SO_BINDTODEVICE que a un network namespace.
— Yo: Entonces HAProxy se queda en la VRF por defecto y solo el frontend hace bind dentro de la pública (bind 203.0.113.10:443 interface vrf-public). Los backends siguen usando las rutas del underlay, y la VIP de Keepalived vive en vrf-public junto al frontend. Varios proxies pueden compartir una VRF; en el momento en que comparten un puerto, las herramientas obligan a usar IPs distintas.
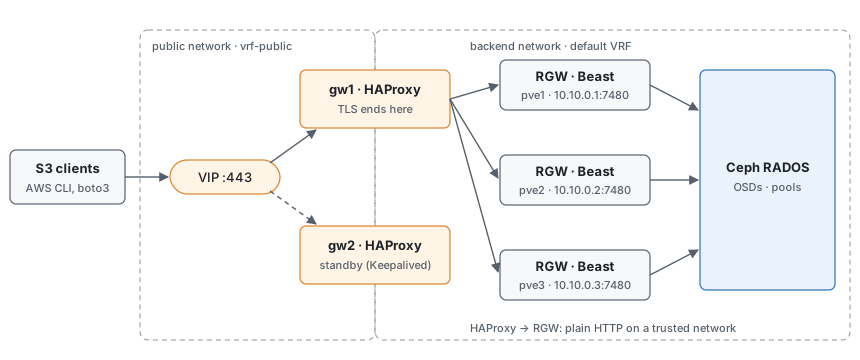
Esto es un subsistema propio, no una casilla debajo de Ceph, y no debe pegarse a SDN. SDN es territorio de overlays de tenants, y el ingreso de infraestructura no tiene por qué compartir radio de impacto con los cambios de red de los tenants. Entonces: un “Unified Infrastructure Proxy” configurado a nivel de Datacenter, un panel nuevo junto a ACME y SDN, un worker liviano de systemd por servicio. Para la v1 atiende exactamente un backend, el RadosGW. Poner también la API de PVE detrás es tentador y duplica la superficie de ataque a cambio de poco, así que espera.
— También yo: Y el elefante en la sala: acabas de poner un listener expuesto a Internet en el mismo kernel que tus VMs y tus claves de Ceph. La VRF limita dónde escucha, no a qué puede llegar un HAProxy comprometido. En un nodo hiperconvergente, un pico de tráfico S3 además compite por CPU con las VMs y los OSD.
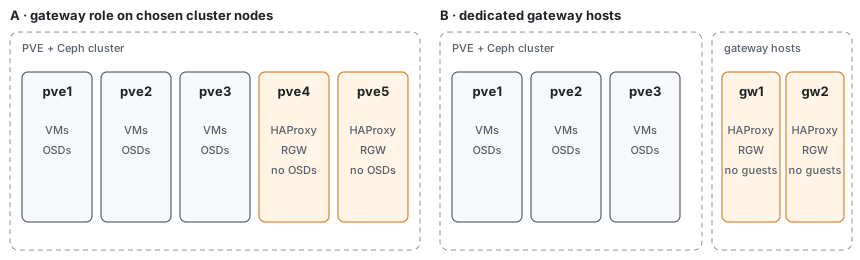
— Yo: Por eso el gateway es un rol, no algo que corren todos los nodos. Yo elijo los nodos, idealmente unos sin OSD, o hosts dedicados de gateway, y las unidades de systemd llevan CPUQuota= y MemoryMax= para que un bucket ocupado no deje sin recursos a una VM. Si eso todavía queda demasiado cerca para tu gusto, el mismo diseño corre en hosts sin ningún huésped.
Alta disponibilidad: elige tu veneno
Eso deja la pregunta que importa más que cualquier sintaxis de configuración: ¿qué pasa cuando se muere un nodo gateway? Tres opciones, y nada es gratis:
- Ingreso activo único (failover). HAProxy + Keepalived, una VIP flotante, un nodo recibiendo el tráfico y balanceándolo entre todos los daemons RGW. Failover para el ingreso, no para los backends. Estable, modelo mental simple, algo de throughput desperdiciado. Tiene la misma forma que el propio ingreso RGW de
cephadmen Ceph, así que puedo tomar prestada lógica de configuración probada sin arrastrarcephadmcomo un segundo plano de control. - Reparto de carga todo activo. DNS round-robin entre el HAProxy de cada gateway. Genial para el throughput, pero la corrección depende de que el resolver descarte los nodos muertos, y el DNS estándar no hace ningún chequeo de salud. Un nodo muerto sigue repartiendo su IP y los clientes siguen chocando con fallas. Best-effort como mucho, no algo que llamaría alta disponibilidad sin que se me escape la risa.
- Anycast (avanzado, opcional). Una VIP S3 anunciada desde cada gateway por BGP/EVPN, que PVE SDN ya habla vía FRR. Con BFD converge más rápido que VRRP; con los temporizadores BGP por defecto, más lento. ECMP además vuelve a calcular el hash de los flujos cada vez que un nodo entra o sale, lo que mata las subidas multipart largas en curso. Y vuelve a meter la dependencia de SDN/FRR, justo eso de lo que me acabo de desacoplar. Estrictamente opcional, para sitios que ya corren un fabric enrutado.
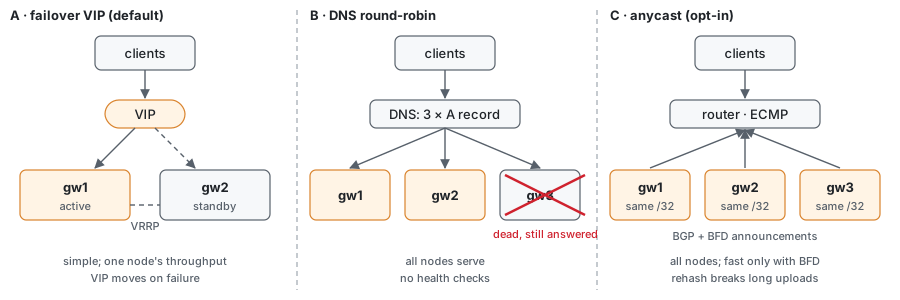
Entregar failover como opción por defecto, exponer las otras dos como decisiones deliberadas. Lo que no se puede defender es entregar DNS round-robin como si fuera HA cuando nada le está chequeando la salud.
Certificados, eso que te despierta a las 3 de la mañana
Los certificados van en pmxcfs, igual que cualquier otro secreto: dejas el certificado y la clave bajo /etc/pve/priv/<service>/ y todos los nodos los ven. Es el patrón que PVE ya usa para las contraseñas de almacenamiento (/etc/pve/priv/storage/<id>.pw), y no necesita ningún parche en C de pmxcfs: se permiten rutas privadas arbitrarias, y los blobs de certificados en crudo no son la configuración estructurada que hay que registrar.
— También yo: Replicar un archivo no es desplegar un certificado. Nada le avisa a HAProxy en los otros nodos que cambió. Y el soporte ACME de PVE hoy es por nodo: Node → Certificates para los certificados, Datacenter → ACME para las cuentas y los plugins DNS. No hay ningún certificado a nivel de clúster del cual colgar esto.
— Yo: Entonces es código nuevo, construido sobre la plomería ACME y no al costado. Un líder de renovación, elegido con un lock de pmxcfs para que los nodos no se abalancen en estampida sobre la CA, escribe el certificado e incrementa un archivo de versión. Cada nodo gateway revisa ese archivo con un temporizador y recarga HAProxy cuando cambia. Sin trucos de inotify sobre un sistema de archivos FUSE.
DNS-01 es el valor por defecto. No le importa qué nodo responde, así que no se pelea con la VIP, y es la única forma de obtener el certificado comodín que necesitan los buckets virtual-hosted (bucket.s3.example.com), junto con DNS comodín y rgw_dns_name. HTTP-01 no es imposible, pero el plugin standalone de PVE quiere el puerto 80 para él solo, lo que choca con HAProxy siendo dueño del endpoint. Luego un systemctl reload cambia el certificado: las conexiones establecidas terminan en el proceso viejo, y solo un puñado de conexiones nuevas pueden fallar durante el traspaso. Configura hard-stop-after para que los workers viejos que atienden transferencias S3 largas no se queden colgados para siempre.
Quién puede tocar qué
— Yo: ¿Ahora estoy construyendo un explorador de archivos S3 dentro de Proxmox?
— También yo: Ni loco. Proxmox es el plano de control, no un administrador de archivos del plano de datos.
La superficie de administración es aprovisionamiento y salud: pveceph rgw create/destroy <id> para el ciclo de vida de los daemons, un panel Datacenter → Ceph → Object Storage para la salud del realm y la distribución de los daemons, el asistente de placement, y una GUI delgada sobre radosgw-admin para crear usuarios, rotar claves y fijar cuotas.
La superficie del tenant se mantiene mínima: URL del endpoint, ver/rotar claves, vigilar la cuota, tal vez crear un bucket. Cada operación real sobre objetos, PUT/GET, multipart, ACLs, CORS, pasa por clientes S3 de verdad (AWS CLI, boto3). No voy a reimplementar el camino de datos de S3 dentro de la interfaz de un hipervisor, y cualquier versión de mí que sugiera lo contrario debería ser escoltada fuera de la reunión.
— También yo: Prolijo. Salvo que “el tenant” no es algo que PVE realmente tenga.
— Yo: No, no lo es. PVE tiene usuarios, grupos, realms y ACLs, pero ningún objeto tenant nativo. Alguien tiene que decidir a qué corresponde un tenant: lo más probable, un grupo de PVE que comparte una identidad S3 y un juego de claves, controlado por un nuevo conjunto de privilegios (S3.Allocate, S3.KeyManage, S3.Audit) a través de la maquinaria normal de ACL. Y a la especificación todavía le faltan cosas que los tenants quieren desde el primer día: revocación de claves, no solo rotación; versionado y ciclo de vida de buckets; alertas de cuota. Hasta que eso no quede definido, estoy describiendo una interfaz que todavía no diseñé.
Autenticación, donde PVE admite sus límites
Los tenants no pueden entrar a S3 con su contraseña de Proxmox. Los tickets de sesión de PVE y SigV4 no interoperan, así que lo que haces es aprovisionar identidad en lugar de hacer de proxy de los logins. Un directorio o IdP compartido detrás de ambos, LDAP u OIDC, es lo más cerca que llegas de “las mismas credenciales”. Dos modos:
- Autenticación nativa aislada (por defecto). Proxmox ejecuta
radosgw-admin user createy entrega claves de acceso/secretas independientes, separadas de los logins de PVE. Una contraseña de PVE filtrada no es un bucket filtrado, y viceversa. - Federación de identidad (OIDC/STS). Los clientes cambian un JWT por credenciales temporales a través del endpoint STS de RGW (
AssumeRoleWithWebIdentity). Esto es más que “apuntar RGW a Keycloak”: el plano de control tiene que aprovisionar un objeto de proveedor OIDC en RGW, roles IAM con políticas de confianza, políticas de permisos por rol, y definir cómo un grupo de PVE se mapea a esos roles. Del lado de RGW también implicargw_s3_auth_use_sts = truey el mismorgw_sts_keyen cada gateway, las dos opciones con las que todo el mundo tropieza. El mapeo es la mitad poco glamorosa, y justo donde cualquiera que haya cableado STS va a ir a pinchar primero.
Ambos mantienen a PVE fuera del camino de las peticiones. Si la interfaz de administración está caída, los buckets siguen respondiendo. Esa es la propiedad que me importa.
La verdad poco glamorosa sobre entregar esto
La API y la interfaz de Proxmox son gloriosamente monolíticas, así que esto no puede ser 100% greenfield. La parte limpia son dos paquetes .deb completamente nuevos: pve-ceph-radosgw para la lógica de backend y la automatización con systemd, y pve-service-gateway para el proxy (pve-infra-proxy era demasiado genérico). La parte sucia es parchear el Proxmox de serie.
— Yo: Parcheo Ceph.pm, meto la interfaz en pvemanagerlib.js, listo.
— También yo: No tan rápido. La CLI vive en PVE/CLI/pveceph.pm, la API bajo PVE/API2/, la interfaz en el árbol modular www/manager6/; pvemanagerlib.js se genera a partir de él.
Después viene el detalle genuinamente ingrato: lograr que los paquetes propios ganen contra los de upstream. Un marcador + no sobrescribe de forma confiable a los de serie: 9.0.1-1+rgw1 se ordena antes que el siguiente 9.0.2-1 de upstream, así que la próxima versión menor lo pasa por encima. La respuesta duradera es rebasar continuamente los paquetes downstream y preferirlos con pins de APT acotados, por paquete, por debajo de 1000; 990 le gana al 500 del repositorio de serie. Con 1000 o más, APT va a hacer downgrade para llegar a la versión fijada, lo cual es activamente peligroso. El tipo de cosa que es invisible justo hasta que te arruina un martes.
— También yo: Y cada uno de esos pins es un pasivo con fecha de vencimiento. Mientras estés fijado, las versiones de pve-manager de upstream, correcciones de seguridad incluidas, esperan hasta que rebases.
— Yo: Por eso los paquetes downstream son un área de preparación, no un destino. El estado final honesto son parches en pve-devel. Un fork es cómo pruebo que el diseño funciona, no cómo quiero operarlo.
Adónde llegué conmigo mismo
La mitad de infraestructura se sostiene: daemons Beast pelados haciendo la traducción tonta en nodos elegidos, un gateway atado a una VRF haciendo el trabajo de cara al público que da miedo, certificados que viajan sobre plomería que ya existe, una identidad que mantiene a PVE fuera del camino de datos, y ni rastro de Kubernetes. La mitad de producto todavía no existe: qué es un tenant y qué puede hacer. Eso es arquitectura, no tarea. Y después está la tarea de verdad: observabilidad, backup y restauración de los metadatos de realm/zona/usuario/claves, y las actualizaciones de Ceph, donde RGW tiene que ir al final y pveceph tiene que saberlo.
De las tres razones por las que esto no iba a funcionar, tengo una respuesta para el listener en los hipervisores, un plan para el fork, y todavía nada para la tenencia.
Así que el diseño se queda como borrador a propósito. La mitad de la arquitectura consiste en dejarla reposar hasta que la parte de ti que encuentra los defectos se aburra y se calle. La mía todavía no se calló, pero por primera vez asiente más de lo que discute, que suele ser la señal de que algo vale la pena construirlo. Los detalles sangrientos (la inicialización del realm, los generadores de HAProxy, la estrategia de empaquetado) viven en mis notas de pve-objectstorage. Si corres RGW junto a PVE y ves un agujero que se me escapó, ahí es donde me lo puedes decir.
Editar este artículo en GitHub · ¿encontraste un error? Los pull requests son bienvenidos.