Proxmox VE e serviços de Object Storage: pensando em voz alta
Eu rodo um cluster PVE com Ceph por baixo. O armazenamento em bloco (RBD) e o sistema de arquivos compartilhado (CephFS) aparecem como cidadãos de primeira classe na interface. O Ceph também traz uma implementação de S3 perfeitamente boa, o RADOS Gateway, e essa eu ainda monto na mão, lá no canto, como um segredo inconfessável.
Então sentei para conversar com a versão de mim que já encontrou três motivos para isso não funcionar: um listener exposto à Internet nos hypervisors, um modelo de tenants que o Proxmox não tem e um fork do pve-manager que eu carregaria para sempre. A pergunta era se trazer o RGW para dentro do Proxmox do jeito certo vale a pena mesmo assim. Não há código para instalar aqui; isto é uma discussão de design, e as anotações de trabalho ficam em pve-objectstorage.
A coceira
— Eu: Eu já tenho o Ceph por baixo. Por que não estou servindo S3 direto dos hypervisors?
— Também eu: Porque hoje você cria isso com radosgw-admin, escreve uma unit do systemd na mão, coloca um balanceador de carga na frente e torce para ninguém mexer nisso no próximo upgrade do cluster. Funciona, mas é um bichinho de estimação, não uma funcionalidade.
Bloco e arquivo não são bichinhos de estimação. Eles são declarados, clusterizados e gerenciados do mesmo lugar que todo o resto. O cluster já está lá, os OSDs já estão lá, os dados já estão lá. A única coisa que falta é o Proxmox tratar o object storage como algo que é dele, e não como algo que eu contrabandeei para dentro.
A resposta da moda é o Rook, ou algum operador de Ceph atrás do MetalLB. Não vou arrastar um control plane de Kubernetes para nós PVE bare-metal só para distribuir buckets S3: um segundo sistema distribuído para cuidar e um segundo domínio de falha, tudo para expor um daemon que o Ceph já compila e o PVE já empacota.
— Também eu: Então fique com a resposta chata do Proxmox. Coloque HAProxy e RGW num container LXC, deixe o ha-manager movê-lo de um lado para outro e não altere nada.
— Eu: Isso é o bichinho de estimação de novo, só que dentro de um container. O guest continua precisando das chaves do Ceph e de uma rota até a rede do cluster, adiciona um salto a cada requisição, e o ciclo de vida continua manual. E sim, o dashboard do Ceph já consegue gerenciar usuários, buckets e quotas do RGW. O que ele não consegue é falar a língua das permissões do PVE nem viver no mesmo painel que todo o resto que eu rodo.
A stack nativa tem tudo de que eu preciso: pveceph, systemd, ifupdown2 com VRFs do Linux, e HAProxy. A restrição se escreve sozinha: systemd nativo + VRF + HAProxy, nada mais.
Daemon burro, e depois cuidar da rede
Mantenha o daemon do RGW simples: RADOS Gateway puro no servidor Beast embutido, ligado a um IP privado na porta 7480 (o padrão simples de rgw_frontends; o cephadm usa a 80), traduzindo HTTP em chamadas ao Ceph. Sem TLS, sem bind público, sem esperteza. Se ele morrer, o systemd traz de volta. O Proxmox cuida da automação sem glamour em volta: chaves de cliente do Ceph, inicialização de realm e zonegroup para uma única zona (multisite fica fora da v1), as units do systemd. As coisas que eu sempre erro de um jeito sutil às 23h.
O tráfego do HAProxy para o Beast atravessa os nós como HTTP puro. O SigV4 protege as credenciais, não o conteúdo, então isso pressupõe uma rede de backend confiável; TLS até os backends continua sendo uma opção para quem não tem uma.
— Eu: Então o assistente de pools é fácil. Escolhe um pool de índice, escolhe um pool de dados.
— Também eu: Não é assim que o RGW pensa. Um bucket recebe um placement target quando é criado, e isso não pode ser mudado depois. Dentro do target, as storage classes são escolhidas por objeto, no upload ou por uma regra de lifecycle.
Então o assistente modela placement targets e suas storage classes, não dois dropdowns de CRUSH. Por baixo disso, claro, uma regra NVMe rápida para o pool de índice replicado, uma regra HDD ou um perfil EC para os dados em massa. E a armadilha que só aparece em produção: um pool de dados com erasure coding precisa de data_extra_pool apontando para um pool replicado, porque EC não consegue guardar omap. Deixe isso sem definir e o RGW volta para o pool de dados EC, e os uploads multipart falham. O assistente deveria definir isso automaticamente, e conviver com a interface de pools e de autoscaler que o PVE já tem, em vez de brigar com ela.
Aí vem a parte em que todos esses designs morrem em silêncio: colocar o HAProxy na frente. Um nó PVE já tem outras coisas que querem a porta 443, em redes que não deveriam se misturar. Faça bind em *:443 e você armou uma mina terrestre curinga: o próximo listener na 443 colide, ou você expõe um endpoint numa rede que ele não tinha nada que tocar. Então a regra é absoluta: o HAProxy nunca faz bind em curingas. IPs explícitos, ponto final, e o gerador se recusa a emitir uma configuração que quebre isso. Para manter o ingress fora do underlay, o frontend público faz bind numa VRF como vrf-public.
— Também eu: Cuidado com essa VRF. Inicie o HAProxy inteiro com ip vrf exec vrf-public e todo socket que ele abrir cai nessa VRF, incluindo as conexões de backend para o RGW na rede privada. Essas morrem a menos que você vaze rotas entre as tabelas. E também não é uma sandbox: ip vrf exec anexa um hook BPF de cgroup que liga os sockets novos ao dispositivo da VRF, mais perto de SO_BINDTODEVICE do que de um network namespace.
— Eu: Então o HAProxy fica na VRF padrão e só o frontend faz bind na pública (bind 203.0.113.10:443 interface vrf-public). Os backends continuam usando as rotas do underlay, e o VIP do Keepalived mora na vrf-public ao lado do frontend. Vários proxies podem compartilhar uma VRF; no momento em que compartilham uma porta, as ferramentas exigem IPs distintos.
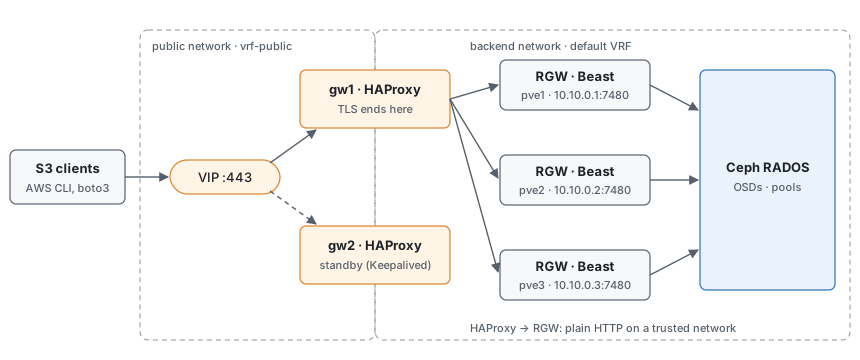
Isto é um subsistema próprio, não uma caixinha de seleção dentro do Ceph, e não pode ser colado no SDN. O SDN é território de overlay de tenants, e o ingress de infraestrutura não tem nada que compartilhar raio de explosão com mudanças na rede dos tenants. Então: um “Unified Infrastructure Proxy” configurado no nível de Datacenter, um painel novo ao lado de ACME e SDN, um worker leve do systemd por serviço. Na v1 ele fica na frente de exatamente um backend, o RadosGW. Ficar na frente da API do PVE também é tentador, mas dobra a superfície de ataque para pouco ganho, então fica para depois.
— Também eu: E o elefante na sala: você acabou de colocar um listener exposto à Internet no mesmo kernel das suas VMs e das suas chaves do Ceph. A VRF limita onde ele escuta, não o que um HAProxy comprometido consegue alcançar. Num nó hiperconvergente, um pico de tráfego S3 também disputa CPU com VMs e OSDs.
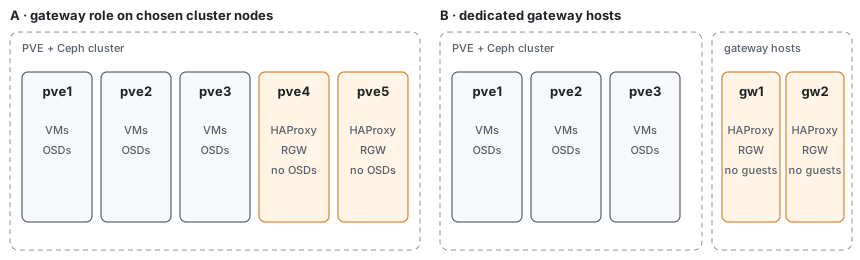
— Eu: É por isso que o gateway é um papel, não algo que todo nó roda. Eu escolho os nós, de preferência sem OSDs, ou hosts de gateway dedicados, e as units do systemd recebem CPUQuota= e MemoryMax= para que um bucket movimentado não deixe uma VM passando fome. Se ainda assim ficar perto demais para o meu gosto, o mesmo design roda em hosts sem nenhum guest.
Alta disponibilidade: escolha seu veneno
Sobra a pergunta que importa mais do que qualquer sintaxe de configuração: o que acontece quando um nó de gateway morre? Três opções, e nenhum almoço grátis:
- Ingress ativo único (failover). HAProxy + Keepalived, um VIP flutuante, um nó recebendo o tráfego e balanceando entre todos os daemons RGW. Failover para o ingress, não para os backends. Estável, modelo mental simples, um pouco de throughput deixado na mesa. É o mesmo formato do ingress de RGW do próprio
cephadmdo Ceph, então dá para aproveitar uma lógica de configuração comprovada sem arrastar ocephadmcomo um segundo control plane. - Compartilhamento de carga todo ativo. DNS round-robin entre o HAProxy de cada gateway. Ótimo para throughput, mas a correção depende de o resolver descartar nós mortos, e o DNS padrão não faz nenhum health check. Um nó morto continua distribuindo seu IP e os clientes continuam batendo em falhas. No máximo best-effort, não algo que eu chamaria de alta disponibilidade sem rir.
- Anycast (avançado, opcional). Um único VIP S3 anunciado por todos os gateways via BGP/EVPN, que o SDN do PVE já fala via FRR. Com BFD, converge mais rápido que o VRRP; com os timers padrão do BGP, mais devagar. O ECMP também refaz o hash dos fluxos sempre que um nó entra ou sai, o que mata uploads multipart longos em andamento. E traz de volta a dependência de SDN/FRR, justamente aquilo de que eu acabei de me desacoplar. Estritamente opcional, para quem já roda uma fabric roteada.
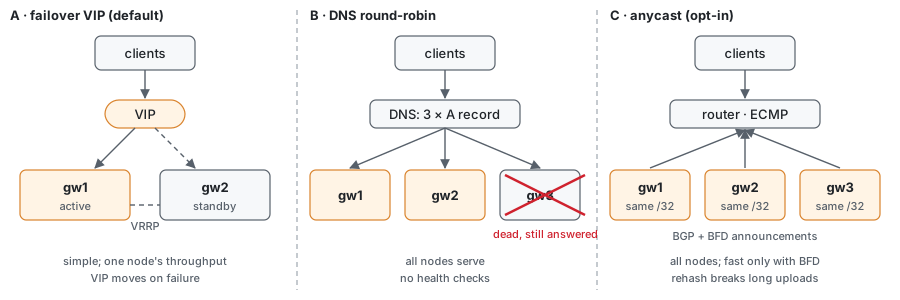
Entregar failover como padrão e expor as outras duas como escolhas deliberadas. O que não tem defesa é entregar DNS round-robin como se fosse HA quando nada está fazendo health check dele.
Certificados, a coisa que te acorda às 3 da manhã
Os certificados vão no pmxcfs, como qualquer outro segredo: coloque o certificado e a chave em /etc/pve/priv/<service>/ e todos os nós os enxergam. É o padrão que o PVE já usa para senhas de storage (/etc/pve/priv/storage/<id>.pw), e não precisa de patch em C no pmxcfs: caminhos privados arbitrários são permitidos, e blobs crus de certificado não são a configuração estruturada que precisa ser registrada.
— Também eu: Replicar um arquivo não é implantar um certificado. Nada avisa o HAProxy nos outros nós que ele mudou. E o suporte a ACME do PVE hoje é por nó: Node → Certificates para os certificados, Datacenter → ACME para contas e plugins de DNS. Não existe um certificado de cluster inteiro onde pendurar isso.
— Eu: Então é código novo, construído sobre o encanamento do ACME em vez de ao lado dele. Um líder de renovação, eleito com um lock do pmxcfs para que os nós não saiam correndo em manada para a CA, grava o certificado e incrementa um arquivo de versão. Cada nó de gateway verifica esse arquivo num timer e recarrega o HAProxy quando ele muda. Nada de truques com inotify num sistema de arquivos FUSE.
DNS-01 é o padrão. Não importa qual nó responde, então não briga com o VIP, e é o único jeito de obter o certificado curinga de que os buckets virtual-hosted (bucket.s3.example.com) precisam, junto com DNS curinga e rgw_dns_name. HTTP-01 não é impossível, mas o plugin standalone do PVE quer a porta 80 só para ele, o que colide com o HAProxy sendo dono do endpoint. Um systemctl reload então troca o certificado: as conexões estabelecidas terminam no processo antigo, e só um punhado de conexões novas pode falhar durante a troca. Configure hard-stop-after para que workers antigos servindo transferências S3 longas não fiquem pendurados para sempre.
Quem pode mexer em quê
— Eu: Agora eu vou construir um navegador de arquivos S3 dentro do Proxmox?
— Também eu: De jeito nenhum. O Proxmox é o control plane, não um gerenciador de arquivos do data plane.
A superfície de administração é provisionamento e saúde: pveceph rgw create/destroy <id> para o ciclo de vida do daemon, um painel Datacenter → Ceph → Object Storage para a saúde do realm e a distribuição dos daemons, o assistente de placement e uma GUI fina sobre o radosgw-admin para criar usuários, rotacionar chaves, definir quotas.
A superfície dos tenants fica minúscula: URL do endpoint, ver/rotacionar chaves, acompanhar a quota, talvez criar um bucket. Toda operação real com objetos, PUT/GET, multipart, ACLs, CORS, passa por clientes S3 de verdade (AWS CLI, boto3). Não vou reimplementar o caminho de dados do S3 dentro da interface de um hypervisor, e qualquer versão de mim que sugerir o contrário deveria ser escoltada para fora da reunião.
— Também eu: Arrumadinho. Só que “o tenant” não é algo que o PVE realmente tenha.
— Eu: Não, não é. O PVE tem usuários, grupos, realms e ACLs, mas nenhum objeto tenant nativo. Alguém precisa decidir a que um tenant corresponde: mais provavelmente um grupo do PVE compartilhando uma identidade S3 e um conjunto de chaves, controlado por um novo conjunto de privilégios (S3.Allocate, S3.KeyManage, S3.Audit) pela maquinaria normal de ACLs. E a especificação ainda não tem coisas que os tenants querem desde o primeiro dia: revogação de chaves, não só rotação; versionamento e lifecycle de buckets; alertas de quota. Até isso ser definido, estou descrevendo uma interface que ainda não desenhei.
Autenticação, onde o PVE admite seus limites
Os tenants não conseguem fazer login no S3 com a senha do Proxmox. Os tickets de sessão do PVE e o SigV4 não interoperam, então você provisiona identidade em vez de fazer proxy de logins. Um diretório ou IdP compartilhado por trás dos dois, LDAP ou OIDC, é o mais perto que você chega de “as mesmas credenciais”. Dois modos:
- Autenticação nativa isolada (padrão). O Proxmox roda
radosgw-admin user createe entrega access/secret keys independentes, separadas dos logins do PVE. Uma senha do PVE vazada não é um bucket vazado, e vice-versa. - Federação de identidade (OIDC/STS). Os clientes trocam um JWT por credenciais temporárias via o endpoint STS do RGW (
AssumeRoleWithWebIdentity). Isso é mais do que “apontar o RGW para o Keycloak”: o control plane precisa provisionar um objeto de provedor OIDC no RGW, roles IAM com trust policies, políticas de permissão por role, e definir como um grupo do PVE se mapeia nessas roles. Do lado do RGW, isso também significargw_s3_auth_use_sts = truee o mesmorgw_sts_keyem todos os gateways, as duas configurações em que todo mundo tropeça. O mapeamento é a metade sem glamour, e exatamente onde qualquer um que já configurou STS vai cutucar primeiro.
Os dois mantêm o PVE fora do caminho das requisições. Se a interface de gerenciamento cair, os buckets continuam respondendo. Essa é a propriedade que me importa.
A verdade sem glamour sobre entregar isso
A API e a interface do Proxmox são gloriosamente monolíticas, então isso não pode ser 100% greenfield. A parte limpa são dois pacotes .deb totalmente novos: pve-ceph-radosgw para a lógica de backend e a automação do systemd, e pve-service-gateway para o proxy (pve-infra-proxy era genérico demais). A parte bagunçada é aplicar patches no Proxmox padrão.
— Eu: Patch no Ceph.pm, joga a interface no pvemanagerlib.js, pronto.
— Também eu: Não exatamente. A CLI fica em PVE/CLI/pveceph.pm, a API em PVE/API2/, a interface na árvore modular www/manager6/; o pvemanagerlib.js é gerado a partir dela.
Aí vem o detalhe genuinamente ingrato: fazer os pacotes customizados ganharem dos de upstream. Um marcador + não sobrepõe o padrão de forma confiável: 9.0.1-1+rgw1 ordena antes do próximo 9.0.2-1 de upstream, então a próxima versão pontual passa na frente. A resposta duradoura é fazer rebase contínuo dos pacotes downstream e preferi-los com pins do APT estreitos, por pacote, abaixo de 1000; 990 ganha dos 500 do repositório padrão. Com 1000 ou mais, o APT vai fazer downgrade para chegar à versão fixada, o que é ativamente perigoso. O tipo de coisa que é invisível até o momento em que estraga uma terça-feira.
— Também eu: E cada um desses pins é um passivo com prazo. Enquanto você estiver fixado, as versões do pve-manager de upstream, correções de segurança incluídas, esperam até você fazer o rebase.
— Eu: É por isso que os pacotes downstream são uma área de preparação, não um destino. O estado final honesto são patches na pve-devel. Um fork é como eu provo que o design funciona, não como quero rodá-lo.
Onde cheguei comigo mesmo
A metade de infraestrutura se sustenta: daemons Beast puros fazendo a tradução burra em nós escolhidos, um gateway preso a uma VRF fazendo o trabalho assustador de cara para o público, certificados andando sobre um encanamento que já existe, identidade que mantém o PVE fora do caminho dos dados, nenhum Kubernetes à vista. A metade de produto ainda não existe: o que é um tenant e o que ele pode fazer. Isso é arquitetura, não lição de casa. E depois tem a lição de casa de verdade: observabilidade, backup e restauração dos metadados de realm/zone/user/key, e upgrades do Ceph, em que o RGW tem que ir por último e o pveceph tem que saber disso.
Dos três motivos para isso não funcionar, tenho uma resposta para o listener nos hypervisors, um plano para o fork e nada ainda para a tenancy.
Então o design continua um rascunho de propósito. Metade da arquitetura é deixar a coisa descansar até que a parte de você que encontra os defeitos fique entediada e se cale. A minha ainda não se calou, mas pela primeira vez ela está mais concordando com a cabeça do que discutindo, o que costuma ser o sinal de que algo vale a pena ser construído. Os detalhes sangrentos (inicialização do realm, os geradores de HAProxy, a estratégia de empacotamento) ficam nas minhas anotações em pve-objectstorage. Se você roda RGW ao lado do PVE e vê um buraco que eu deixei passar, é lá que você me conta.
Editar este post no GitHub · achou um erro? Pull requests são bem-vindos.