Proxmox VE e servizi di object storage: pensando ad alta voce
Gestisco un cluster PVE basato su Ceph. Lo storage a blocchi (RBD) e il filesystem condiviso (CephFS) compaiono nell’interfaccia come cittadini di prima classe. Ceph include anche un’implementazione S3 più che dignitosa, il RADOS Gateway, e quella la configuro ancora a mano, in disparte, come un segreto inconfessabile.
Così mi sono seduto con la versione di me che ha già trovato tre motivi per cui non funzionerà: un listener esposto a Internet sugli hypervisor, un modello di tenant che Proxmox non ha, e un fork di pve-manager da portarmi dietro per sempre. La domanda era se valga comunque la pena integrare RGW in Proxmox come si deve. Qui non c’è codice da installare; è una discussione di design, e gli appunti di lavoro stanno in pve-objectstorage.
Il prurito
— Io: Ho già Ceph sotto il cofano. Perché non servo S3 direttamente dagli hypervisor?
— Sempre io: Perché oggi lo crei con radosgw-admin, scrivi a mano una unit systemd, ci metti davanti un load balancer e speri che nessuno lo tocchi durante il prossimo upgrade del cluster. Funziona, ma è un animaletto domestico, non una funzionalità.
Blocchi e file non sono animaletti domestici. Sono dichiarati, in cluster, e gestiti dallo stesso posto di tutto il resto. Il cluster c’è già, gli OSD ci sono già, i dati ci sono già. L’unica cosa che manca è che Proxmox tratti l’object storage come qualcosa di suo invece che come qualcosa che ho fatto entrare di contrabbando.
La risposta alla moda è Rook, o qualche operator Ceph dietro MetalLB. Non mi trascino un control plane Kubernetes su nodi PVE bare-metal per distribuire bucket S3: un secondo sistema distribuito da accudire e un secondo dominio di guasto, tutto per esporre un demone che Ceph già compila e PVE già pacchettizza.
— Sempre io: Allora prendi la risposta noiosa alla Proxmox. Metti HAProxy e RGW in un container LXC, lascia che ha-manager lo sposti, e non patchare niente.
— Io: È di nuovo l’animaletto domestico, solo dentro un container. Il guest ha comunque bisogno delle chiavi Ceph e di una rotta verso la rete del cluster, aggiunge un salto a ogni richiesta, e il suo ciclo di vita resta manuale. E sì, la dashboard di Ceph sa già gestire utenti, bucket e quote di RGW. Quello che non sa fare è parlare i permessi di PVE o vivere nello stesso pannello di tutto il resto che gestisco.
Lo stack nativo ha tutto ciò che mi serve: pveceph, systemd, ifupdown2 con le VRF di Linux, e HAProxy. Il vincolo si scrive da solo: systemd nativo + VRF + HAProxy, nient’altro.
Il demone resta stupido, poi occhio alla rete
Il demone RGW resta semplice: RADOS Gateway nudo sul server Beast integrato, in ascolto su un IP privato sulla porta 7480 (il default di rgw_frontends puro; cephadm usa la 80), a tradurre HTTP in chiamate Ceph. Niente TLS, niente binding pubblico, niente furbizie. Se muore, systemd lo rimette in piedi. Proxmox si occupa dell’automazione poco glamour intorno: chiavi client Ceph, inizializzazione di realm e zonegroup per una singola zona (il multisite resta fuori dalla v1), le unit systemd. Le cose che sbaglio sempre in modo sottile alle 11 di sera.
Il traffico da HAProxy a Beast attraversa i nodi in HTTP in chiaro. SigV4 protegge le credenziali, non il payload, quindi questo presuppone una rete di backend fidata; il TLS verso i backend resta un’opzione per i siti che non ne hanno una.
— Io: Il wizard dei pool è facile, allora. Scegli un pool per l’indice, scegli un pool per i dati.
— Sempre io: Non è così che ragiona RGW. Un bucket riceve un placement target quando viene creato, e non si può cambiare dopo. Dentro il target, le storage class si scelgono per oggetto, al momento dell’upload o tramite una regola di lifecycle.
Quindi il wizard modella i placement target e le loro storage class, non due menu a tendina di CRUSH. Sotto, certo, una regola NVMe veloce per il pool replicato dell’indice, una regola HDD o un profilo EC per i dati in massa. E la trappola che salta fuori solo in produzione: un pool dati erasure-coded ha bisogno di data_extra_pool puntato a un pool replicato, perché EC non può contenere omap. Se lo lasci vuoto, RGW ripiega sul pool dati EC e gli upload multipart falliscono. Il wizard dovrebbe impostarlo da solo, e convivere con l’interfaccia di pool e autoscaler che PVE ha già invece di farle la guerra.
Poi arriva la parte su cui ogni design di questo tipo muore in silenzio: mettere HAProxy davanti. Un nodo PVE ha già altre cose che vogliono la porta 443, su reti che non c’entrano l’una con l’altra. Fai il bind su *:443 e hai innescato una mina wildcard: il prossimo listener sulla 443 va in conflitto, oppure esponi un endpoint su una rete che non aveva nessun motivo di toccare. Quindi la regola è assoluta: HAProxy non fa mai bind su wildcard. IP espliciti, punto, e il generatore si rifiuta di emettere una configurazione che violi questa regola. Per tenere l’ingress fuori dall’underlay, il frontend pubblico fa il bind dentro una VRF come vrf-public.
— Sempre io: Attento con quella VRF. Avvia l’intero HAProxy con ip vrf exec vrf-public e ogni socket che apre finisce in quella VRF, comprese le connessioni di backend verso RGW sulla rete privata. Quelle muoiono a meno che tu non faccia leaking delle rotte tra le tabelle. Non è nemmeno una sandbox: ip vrf exec aggancia un hook BPF di cgroup che lega i nuovi socket al device della VRF, più vicino a SO_BINDTODEVICE che a un network namespace.
— Io: Quindi HAProxy resta nella VRF di default e solo il frontend fa il bind in quella pubblica (bind 203.0.113.10:443 interface vrf-public). I backend continuano a usare le rotte dell’underlay, e il VIP di Keepalived vive in vrf-public accanto al frontend. Più proxy possono condividere una VRF; nel momento in cui condividono una porta, gli strumenti impongono IP distinti.
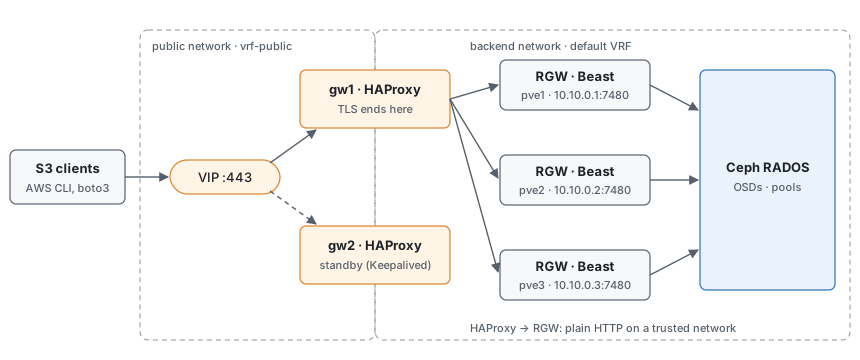
Questo è un sottosistema a sé, non una casella da spuntare sotto Ceph, e non va incollato sopra SDN. SDN è territorio degli overlay dei tenant, e l’ingress dell’infrastruttura non ha nessun motivo di condividere il raggio d’esplosione con le modifiche alla rete dei tenant. Quindi: un “Unified Infrastructure Proxy” configurato a livello di Datacenter, un nuovo pannello accanto ad ACME e SDN, un worker systemd leggero per servizio. Per la v1 sta davanti a un solo backend, il RadosGW. Metterlo davanti anche all’API di PVE è allettante e raddoppia la superficie d’attacco per poco guadagno, quindi aspetta.
— Sempre io: E poi l’elefante nella stanza: hai appena messo un listener esposto a Internet sullo stesso kernel delle tue VM e delle tue chiavi Ceph. La VRF limita dove ascolta, non cosa può raggiungere un HAProxy compromesso. Su un nodo iperconvergente, un picco di traffico S3 compete anche con VM e OSD per la CPU.
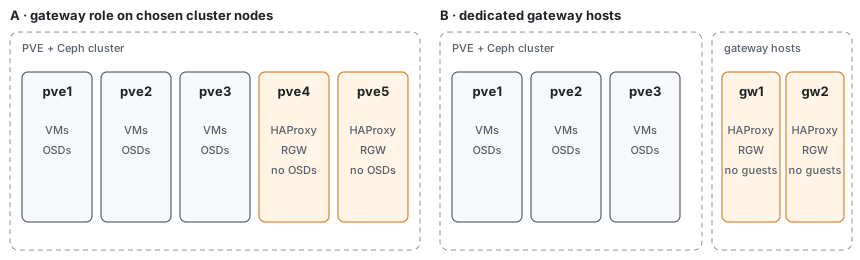
— Io: Ed è per questo che il gateway è un ruolo, non qualcosa che gira su ogni nodo. Scelgo io i nodi, idealmente quelli senza OSD, o host gateway dedicati, e le unit systemd ricevono CPUQuota= e MemoryMax= così un bucket impegnato non può affamare una VM. Se è ancora troppo vicino per stare tranquilli, lo stesso design gira su host senza alcun guest.
Alta disponibilità, scegli il tuo veleno
Resta la domanda che conta più di qualsiasi sintassi di configurazione: cosa succede quando muore un nodo gateway? Tre opzioni, e nessun pasto gratis:
- Ingress attivo singolo (failover). HAProxy + Keepalived, un VIP flottante, un nodo che prende il traffico e lo bilancia su tutti i demoni RGW. Failover per l’ingress, non per i backend. Stabile, modello mentale semplice, un po’ di throughput lasciato sul tavolo. Ha la stessa forma dell’ingress RGW di
cephadmdi Ceph stesso, quindi posso prendere in prestito una logica di configurazione collaudata senza trascinarmi dentrocephadmcome secondo control plane. - Condivisione del carico tutta attiva. DNS round-robin su tutti gli HAProxy dei gateway. Ottimo per il throughput, ma la correttezza dipende dal resolver che scarta i nodi morti, e il DNS standard non fa nessun health check. Un nodo morto continua a distribuire il suo IP e i client continuano a sbattere contro errori. Al massimo best-effort, non qualcosa che chiamerei altamente disponibile senza ridere.
- Anycast (avanzato, opt-in). Un unico VIP S3 annunciato da ogni gateway via BGP/EVPN, che PVE SDN parla già tramite FRR. Con BFD converge più in fretta di VRRP; con i timer BGP di default è più lento. ECMP inoltre rimescola gli hash dei flussi ogni volta che un nodo entra o esce, il che uccide i lunghi upload multipart in corso. E si riporta dietro proprio la dipendenza da SDN/FRR, la cosa da cui mi ero appena sganciato. Rigorosamente opt-in, per i siti che hanno già un fabric routed.
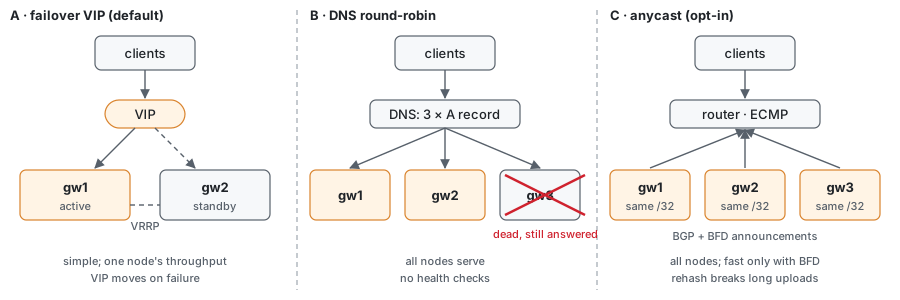
Distribuire il failover come default, esporre le altre due come scelte consapevoli. Quello che non è difendibile è distribuire il DNS round-robin come se fosse HA quando niente ne controlla lo stato.
Certificati, la cosa che ti fa squillare il telefono alle 3 di notte
I certificati vanno in pmxcfs, come ogni altro segreto: metti certificato e chiave sotto /etc/pve/priv/<service>/ e ogni nodo li vede. È lo schema che PVE usa già per le password degli storage (/etc/pve/priv/storage/<id>.pw), e non richiede nessuna patch C a pmxcfs: i percorsi privati arbitrari sono ammessi, e i blob grezzi dei certificati non sono la configurazione strutturata che va registrata.
— Sempre io: Replicare un file non è distribuire un certificato. Niente avvisa HAProxy sugli altri nodi che è cambiato. E il supporto ACME di PVE oggi è per nodo: Node → Certificates per i certificati, Datacenter → ACME per account e plugin DNS. Non c’è nessun certificato a livello di cluster a cui appendere questa roba.
— Io: Allora è codice nuovo, costruito sopra l’infrastruttura ACME invece che accanto. Un unico leader del rinnovo, eletto con un lock di pmxcfs così i nodi non prendono d’assalto la CA, scrive il certificato e incrementa un file di versione. Ogni nodo gateway controlla quel file con un timer e ricarica HAProxy quando cambia. Niente trucchi con inotify su un filesystem FUSE.
DNS-01 è il default. Non gli importa quale nodo risponde, quindi non litiga con il VIP, ed è l’unico modo per ottenere il certificato wildcard di cui hanno bisogno i bucket virtual-hosted (bucket.s3.example.com), insieme al DNS wildcard e a rgw_dns_name. HTTP-01 non è impossibile, ma il plugin standalone di PVE vuole la porta 80 tutta per sé, il che va in conflitto con HAProxy padrone dell’endpoint. Poi un systemctl reload scambia il certificato: le connessioni già stabilite finiscono sul vecchio processo, e solo una manciata di nuove connessioni può fallire durante il passaggio. Imposta hard-stop-after così i vecchi worker che servono lunghi trasferimenti S3 non restano appesi per sempre.
Chi può toccare cosa
— Io: Adesso mi metto a costruire un file browser S3 dentro Proxmox?
— Sempre io: Assolutamente no. Proxmox è il control plane, non un file manager del data plane.
La superficie di amministrazione è provisioning e salute: pveceph rgw create/destroy <id> per il ciclo di vita dei demoni, un pannello Datacenter → Ceph → Object Storage per la salute del realm e la distribuzione dei demoni, il wizard di placement, e una GUI sottile sopra radosgw-admin per creare utenti, ruotare chiavi, impostare quote.
La superficie per i tenant resta minuscola: URL dell’endpoint, vedere/ruotare le chiavi, guardare la quota, magari creare un bucket. Ogni vera operazione sugli oggetti, PUT/GET, multipart, ACL, CORS, passa per client S3 veri (AWS CLI, boto3). Non reimplemento il data path di S3 dentro l’interfaccia di un hypervisor, e qualsiasi versione di me che suggerisca il contrario va accompagnata fuori dalla riunione.
— Sempre io: Ordinato. Solo che “il tenant” non è una cosa che PVE abbia davvero.
— Io: No, non lo è. PVE ha utenti, gruppi, realm e ACL, ma nessun oggetto tenant nativo. Qualcuno deve decidere a cosa corrisponde un tenant: molto probabilmente un gruppo PVE che condivide un’unica identità S3 e un set di chiavi, controllato da un nuovo insieme di privilegi (S3.Allocate, S3.KeyManage, S3.Audit) attraverso il normale meccanismo delle ACL. E alla specifica mancano ancora cose che i tenant vogliono dal primo giorno: la revoca delle chiavi, non solo la rotazione; versioning e lifecycle dei bucket; avvisi sulle quote. Finché questo non è definito, sto descrivendo un’interfaccia che non ho ancora progettato.
Autenticazione, dove PVE ammette i suoi limiti
I tenant non possono accedere a S3 con la loro password di Proxmox. I ticket di sessione di PVE e SigV4 non interoperano, quindi l’identità la si provisiona invece di fare da proxy ai login. Una directory o un IdP condiviso dietro entrambi, LDAP o OIDC, è quanto di più vicino ci sia alle “stesse credenziali”. Due modalità:
- Autenticazione nativa isolata (default). Proxmox esegue
radosgw-admin user createe consegna access/secret key indipendenti, separate dai login di PVE. Una password PVE trapelata non è un bucket trapelato, e viceversa. - Federazione delle identità (OIDC/STS). I client scambiano un JWT con credenziali temporanee tramite l’endpoint STS di RGW (
AssumeRoleWithWebIdentity). È più di “punta RGW verso Keycloak”: il control plane deve fare il provisioning di un oggetto OIDC provider di RGW, di ruoli IAM con trust policy, di permission policy per ruolo, e definire come un gruppo PVE si mappa su quei ruoli. Lato RGW significa anchergw_s3_auth_use_sts = truee lo stessorgw_sts_keysu ogni gateway, le due impostazioni su cui inciampano tutti. La mappatura è la metà poco glamour, ed è esattamente dove chiunque abbia configurato STS andrà a frugare per primo.
Entrambe tengono PVE fuori dal percorso delle richieste. Se l’interfaccia di gestione è giù, i bucket continuano a rispondere. È la proprietà che mi interessa.
La verità poco glamour sul distribuire tutto questo
API e interfaccia di Proxmox sono gloriosamente monolitiche, quindi questo non può essere al 100% greenfield. La parte pulita sono due pacchetti .deb completamente nuovi: pve-ceph-radosgw per la logica di backend e l’automazione systemd, e pve-service-gateway per il proxy (pve-infra-proxy era troppo generico). La parte sporca è patchare Proxmox di serie.
— Io: Patcho Ceph.pm, butto l’interfaccia in pvemanagerlib.js, fatto.
— Sempre io: Non proprio. La CLI vive in PVE/CLI/pveceph.pm, l’API sotto PVE/API2/, l’interfaccia nell’albero modulare www/manager6/; pvemanagerlib.js viene generato da lì.
Poi il dettaglio davvero ingrato: far vincere i pacchetti personalizzati su quelli upstream. Un marcatore + non scavalca in modo affidabile quelli di serie: 9.0.1-1+rgw1 viene ordinato prima del successivo 9.0.2-1 upstream, quindi la point release successiva lo sorpassa. La risposta duratura è fare rebase continuo dei pacchetti downstream e preferirli con pin APT stretti, per pacchetto, sotto 1000; 990 batte il 500 del repository di serie. Da 1000 in su, APT fa il downgrade pur di raggiungere la versione pinnata, il che è attivamente pericoloso. Il tipo di cosa che resta invisibile fino al momento in cui ti rovina un martedì.
— Sempre io: E ognuno di quei pin è una passività con una scadenza. Finché sei pinnato, le release upstream di pve-manager, correzioni di sicurezza comprese, aspettano finché non fai il rebase.
— Io: Ed è per questo che i pacchetti downstream sono un’area di parcheggio, non una destinazione. Lo stato finale onesto sono patch su pve-devel. Un fork è il modo in cui dimostro che il design funziona, non il modo in cui voglio gestirlo.
Dove sono arrivato con me stesso
La metà infrastrutturale regge: demoni Beast nudi che fanno la traduzione stupida su nodi scelti, un gateway legato a una VRF che fa il lavoro spaventoso esposto al pubblico, certificati che viaggiano su un’infrastruttura che esiste già, un’identità che tiene PVE fuori dal data path, nessun Kubernetes all’orizzonte. La metà di prodotto non esiste ancora: cos’è un tenant e cosa può fare. Quella è architettura, non compiti a casa. Poi ci sono i compiti a casa veri: osservabilità, backup e restore dei metadati di realm/zone/utenti/chiavi, e gli upgrade di Ceph, dove RGW deve andare per ultimo e pveceph deve saperlo.
Dei tre motivi per cui non avrebbe funzionato, ho una risposta per il listener sugli hypervisor, un piano per il fork, e ancora niente per la tenancy.
Quindi il design resta una bozza di proposito. Metà dell’architettura sta nel lasciarla riposare finché la parte di te che trova i difetti si annoia e sta zitta. La mia non sta ancora zitta, ma per la prima volta annuisce più di quanto discuta, che di solito è il segno che vale la pena costruire qualcosa. I dettagli più crudi (inizializzazione del realm, i generatori di HAProxy, la strategia di pacchettizzazione) stanno nei miei appunti di pve-objectstorage. Se fai girare RGW accanto a PVE e vedi un buco che mi è sfuggito, è lì che devi dirmelo.
Modifica questo articolo su GitHub · hai trovato un errore? Le pull request sono benvenute.